Electronique design
Reconnaissance vocale en darija : ce que l’IA Maroc–Mistral change pour vos projets ESP32 et Raspberry Pi
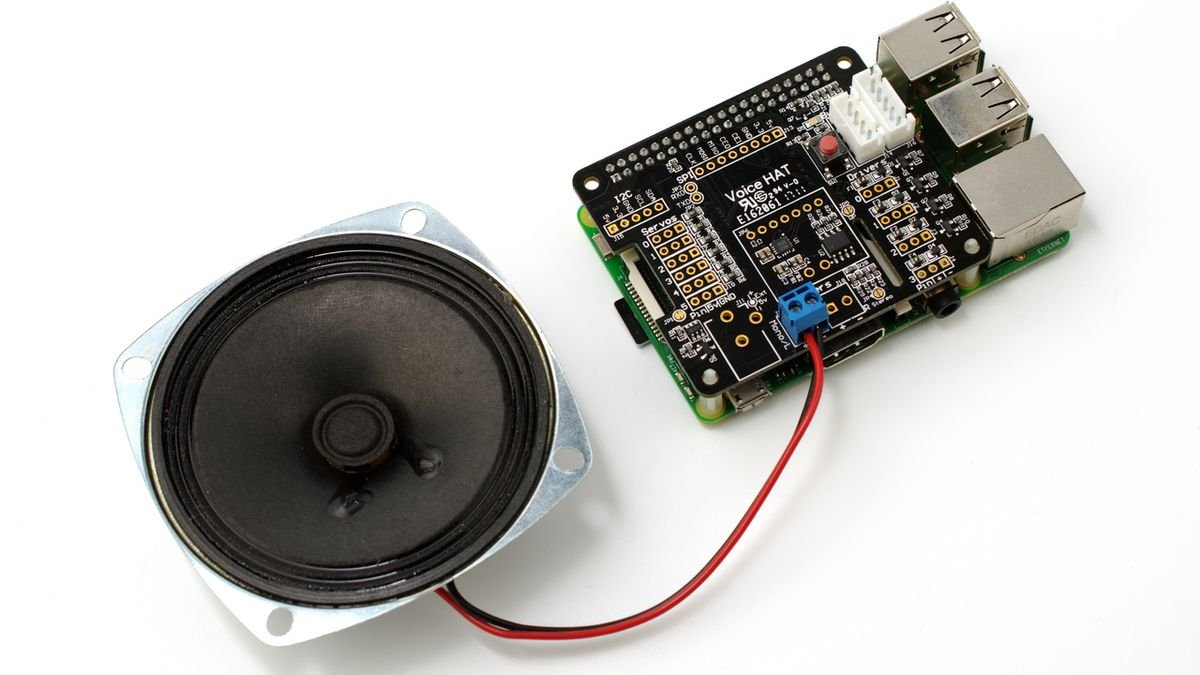
Le 29 septembre 2026, le ministère de la Transition numérique et de la Réforme de l’administration a présenté avec la société française Mistral AI les deux premiers outils issus de leur partenariat. L’un reconnaît la darija parmi plusieurs dialectes arabes, l’autre transcrit la parole en texte, même lorsque l’on passe de l’arabe au français ou à l’anglais au milieu d’une phrase. Le ministère annonce une diffusion prochaine en open source.
Pour les makers, les étudiants et les ingénieurs, la nouvelle ouvre une perspective concrète : des appareils capables de comprendre des consignes formulées comme on parle vraiment au Maroc. Avant de rêver à une lampe qui obéit en darija, il faut toutefois comprendre comment se construit une chaîne de reconnaissance vocale et ce que chaque carte électronique peut réellement prendre en charge.
Ce qui a été annoncé, et ce qui reste à confirmer
Selon le communiqué repris par la presse marocaine, le premier outil est un classificateur d’identification linguistique. Le second est une adaptation à la darija de Voxtral, la famille de modèles de reconnaissance vocale que Mistral AI a lancée en juillet 2025 sous licence Apache 2.0. Ces travaux s’inscrivent dans la stratégie « Maroc Digital 2030 » et la feuille de route « AI Made in Morocco ».
Trois points restent ouverts au moment où nous écrivons. Aucune date de mise en ligne n’a été communiquée, aucun taux d’erreur n’a été publié et la licence exacte des versions adaptées n’est pas encore connue. Il faudra donc tester ces modèles sur vos propres enregistrements, avec des accents variés, avant de bâtir un produit dessus.
Pourquoi la darija complique la tâche des machines
La plupart des systèmes de reconnaissance vocale ont surtout été entraînés sur l’arabe standard moderne, celui des journaux et des textes officiels. La darija s’en écarte nettement : vocabulaire emprunté au français, à l’espagnol et à l’amazigh, orthographe peu fixée, et alternance permanente entre plusieurs langues. Un modèle qui n’a jamais entendu une consigne comme « ch3el d-dow » (allume la lumière) risque de produire une transcription fantaisiste.
C’est précisément ce défaut que l’annonce du 29 septembre cherche à corriger. Pour un objet connecté destiné au grand public marocain, c’est une différence majeure.
Les briques d’une commande vocale
Qu’il s’agisse d’une enceinte du commerce ou d’un montage fait maison, on retrouve presque toujours la même chaîne de traitement :
- La capture du son : un ou plusieurs microphones, le plus souvent de type MEMS à sortie numérique.
- Le prétraitement : réduction du bruit, annulation d’écho et détection de la présence de voix.
- Le mot d’éveil : un petit modèle écoute en permanence et ne réagit qu’à une expression précise.
- La transcription ou la reconnaissance de commandes : la phrase prononcée est convertie en texte ou associée à une action connue.
- L’action : activer une sortie, envoyer un message, répondre par un son.
Les premières étapes demandent peu de calcul et tournent très bien sur un microcontrôleur. La transcription libre d’une phrase, en revanche, exige beaucoup plus de mémoire. Notre article sur l’IA embarquée sur ESP32 et Raspberry Pi détaille ce partage entre petites cartes et ordinateurs monocartes.
Côté matériel : capter une voix proprement
Le microphone MEMS I2S
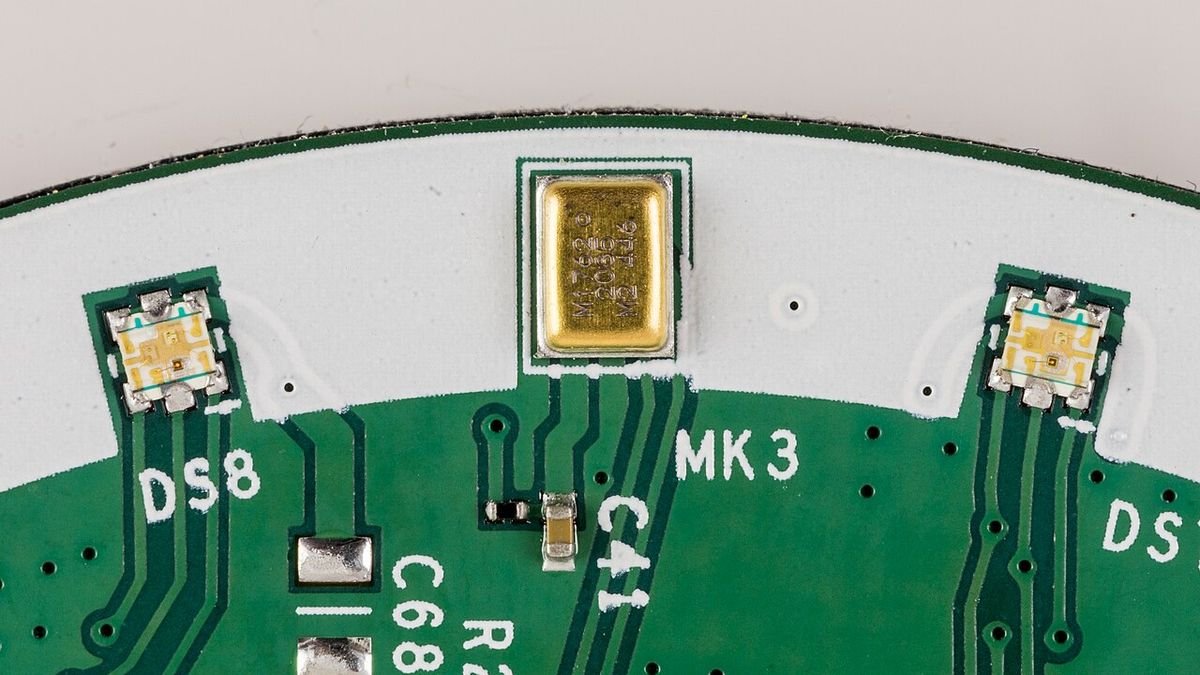
Les microphones MEMS à sortie I2S livrent directement un flux numérique, sans préamplificateur ni convertisseur analogique à câbler. L’INMP441, très répandu en prototypage, fournit des échantillons sur 24 bits avec un rapport signal sur bruit de 61 dBA d’après sa fiche technique. Les enceintes connectées du commerce en intègrent plusieurs autour de leur circuit imprimé, ce qui les aide à isoler la voix et à repérer d’où elle vient.
La restitution sonore
Pour qu’un montage réponde par un bip ou une phrase, un amplificateur à entrée I2S comme le MAX98357A est une solution simple. Ce circuit de classe D mono délivre 3,2 W dans un haut-parleur de 4 Ω sous 5 V, selon sa fiche technique, et se passe d’horloge maître.
Le bon format audio
Inutile de viser la haute fidélité. Le frontal audio d’Espressif attend un flux de 16 kHz sur 16 bits, et l’outil whisper.cpp demande lui aussi un fichier WAV 16 bits, mono, échantillonné à 16 kHz. Soignez plutôt l’emplacement du micro : loin du haut-parleur, d’un ventilateur ou d’un relais qui claque.
Quelle carte pour quel usage ?
ESP32-S3 : mot d’éveil et commandes courtes
La bibliothèque ESP-SR d’Espressif regroupe un frontal audio, le moteur de mot d’éveil WakeNet et le module de commandes MultiNet. D’après sa documentation, MultiNet gère sur ESP32-S3 jusqu’à 200 commandes personnalisables, mais seulement en chinois ou en anglais à ce jour. Il existe en revanche un mot d’éveil français, « Bonjour ESP », et Espressif cite l’arabe parmi les langues prévues pour l’entraînement de nouveaux mots d’éveil. Une carte comme l’ESP32-S3-DevKitC-1-N8R8, avec ses 8 Mo de PSRAM, convient bien à ces essais.
Si vous hésitez encore entre plusieurs familles de puces, relisez nos critères pour choisir le bon microcontrôleur : mémoire, instructions vectorielles et consommation pèsent lourd en traitement audio.
Raspberry Pi : la transcription hors ligne
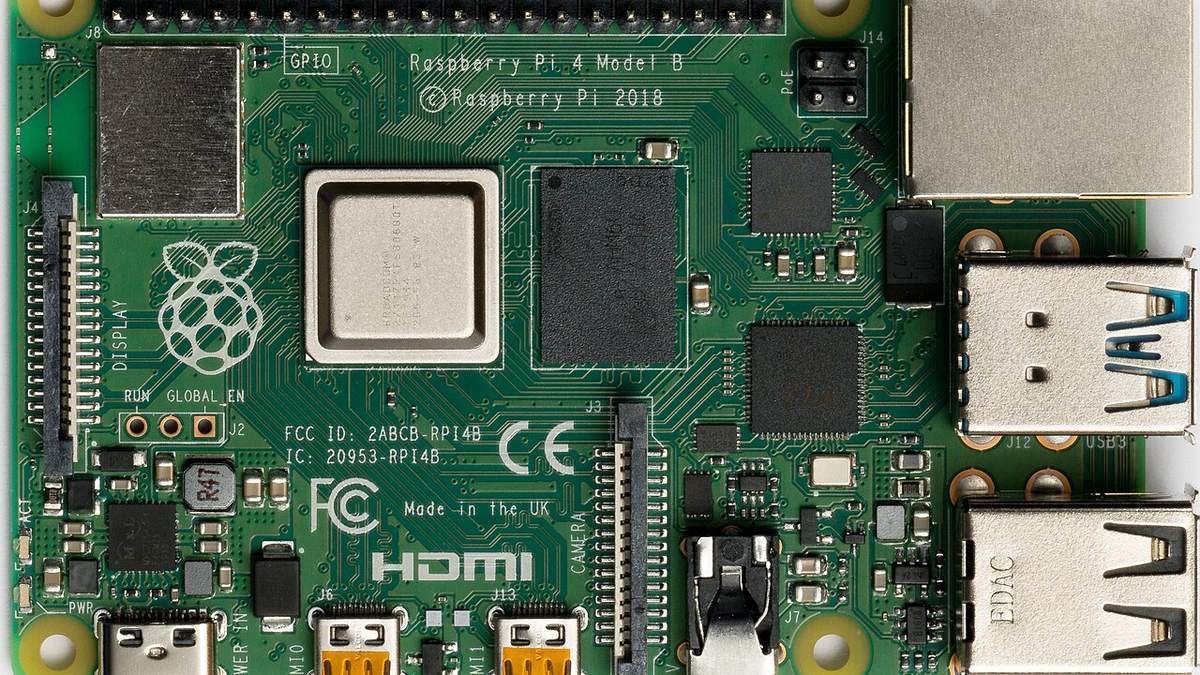
Un Raspberry Pi 4 fonctionne sous Linux et peut exécuter des moteurs de transcription locaux. Le plus petit modèle Whisper, publié sous licence MIT, compte 39 millions de paramètres. Avec whisper.cpp, il occupe 75 Mo sur disque et environ 273 Mo de mémoire vive, et le projet mentionne explicitement la compatibilité avec le Raspberry Pi. Vosk, autre solution hors ligne, propose des modèles compacts d’environ 50 Mo, dont un modèle arabe.
Un serveur pour les gros modèles
Les modèles Voxtral jouent dans une autre catégorie. D’après sa fiche Hugging Face, Voxtral Mini, la version de 3 milliards de paramètres, réclame environ 9,5 Go de mémoire graphique en bf16 ou fp16. L’architecture réaliste consiste alors à confier le mot d’éveil et la capture à la carte embarquée, puis à envoyer le court enregistrement vers un PC équipé d’un GPU ou un serveur local qui renvoie le texte.
Un projet pour se lancer
Commencez par une version 100 % locale : un ESP32-S3, un micro INMP441 et un module relais qui allume une lampe après le mot d’éveil, puis sur une commande courte. Une fois le montage fiable, ajoutez un Raspberry Pi ou un PC pour transcrire des phrases entières et testez les modèles en darija dès leur publication.
Pour la partie puissance, choisissez dans notre rayon relais un modèle dont la bobine correspond à votre tension de commande, prévoyez une diode de roue libre si le module n’en possède pas, et gardez le 220 V à distance de la partie audio. Mesurez enfin le taux de fausses détections sur une journée entière : un assistant qui se déclenche tout seul devient vite pénible.
Ce type de prototype a aussi sa place dans les concours étudiants : le Moroccan Sahara Innovation Challenge de l’Université Cadi Ayyad accepte les candidatures jusqu’au 18 octobre. Nos conseils pour préparer un prototype de compétition vous aideront à le rendre présentable.
À retenir
L’annonce du partenariat Maroc–Mistral AI ne change pas encore le matériel, mais elle pourrait lever le principal obstacle des commandes vocales au Maroc : la langue. En attendant la publication des modèles, préparez une chaîne audio propre, un mot d’éveil fiable et une architecture qui sépare l’écoute locale de la transcription lourde. Le jour où les modèles en darija seront disponibles, il suffira de les brancher au bon endroit.